Materi 16: Memproses Berbagai Tipe Data
Di bab ini, Kita akan belajar cara menangani tipe data yang lebih spesifik: HTML, XML, Tanggal & Waktu, dan Data Biner (file). Ini adalah kemampuan penting untuk menghubungkan sistem yang berbeda.
Bagian 1: HTML dan XML
Seringkali kita perlu mengambil data dari website (HTML) atau layanan lama yang menggunakan XML. n8n memiliki node khusus untuk ini.
Latihan 1: Web Scraping Lanjutan (HTML)
Mari kita coba mengambil data dari blog n8n. Tidak hanya satu, tapi semua artikel di halaman depan, dan kita ingin mengambil Judul beserta Link-nya.
Tantangan:
-
Gunakan HTTP Request untuk mengambil
https://blog.n8n.io/. - Gunakan node HTML untuk mengekstrak data.
- Pastikan Kita mendapatkan Judul DAN Link URL untuk setiap artikel.
- Gunakan opsi Return Array untuk mengambil banyak item.
- Kita bisa menambahkan lebih dari satu "Value" di bagian Extraction Values.
-
Untuk mengambil Link, ubah Return Value menjadi
Attribute dan nama atributnya adalah
href.
👉 Lihat Solusi HTML (Multi-Data)
Langkah 1: HTTP Request
- Method: GET
- URL:
https://blog.n8n.io/
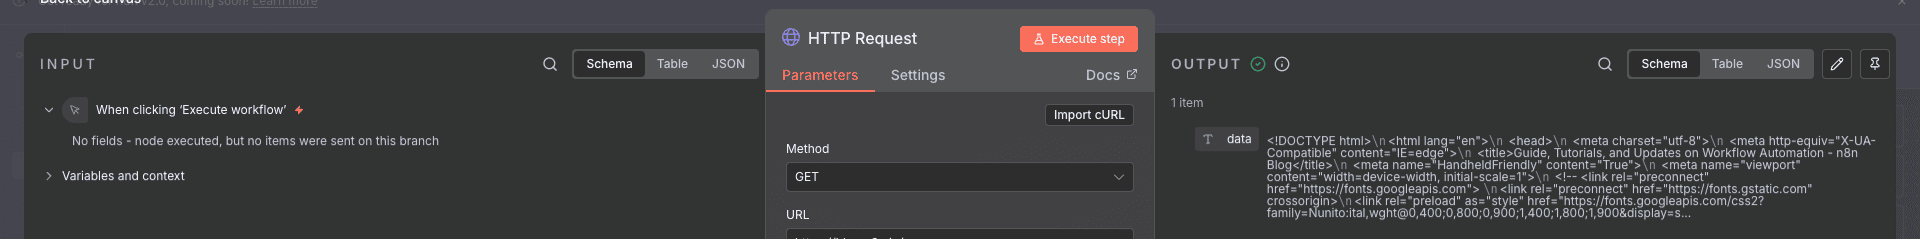
HTTP Request ke blog n8n.
Langkah 2: HTML Node (Konfigurasi)
- Operation: Extract HTML Content
- Source Data: JSON
- Property:
data - Return Array: Aktifkan (ON) ✅
Konfigurasi Extraction Values:
Value 1 (Judul):
- Key:
title - CSS Selector:
.post .item-title a - Return Value: HTML (atau Text)
Value 2 (Link) - Klik 'Add Value':
- Key:
link - CSS Selector:
.post .item-title a - Return Value: Attribute
- Attribute:
href
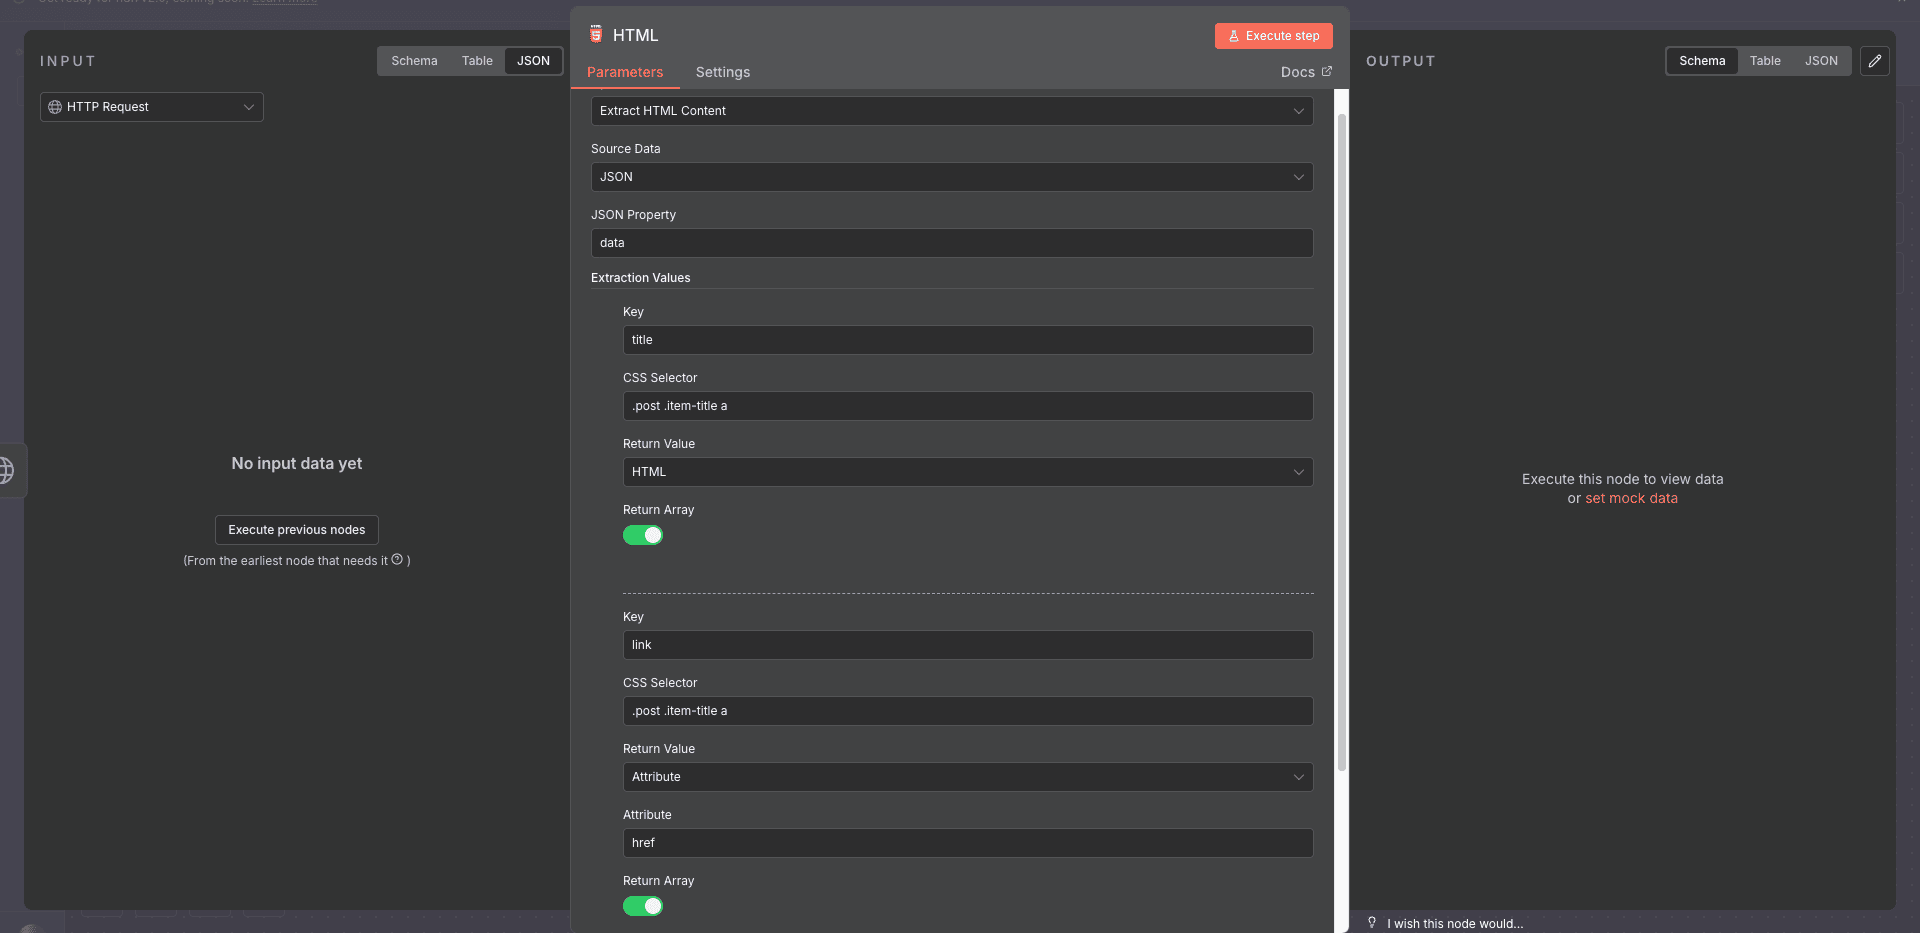
Konfigurasi untuk mengambil Judul (Text) dan Link (Attribute href).
Hasilnya:
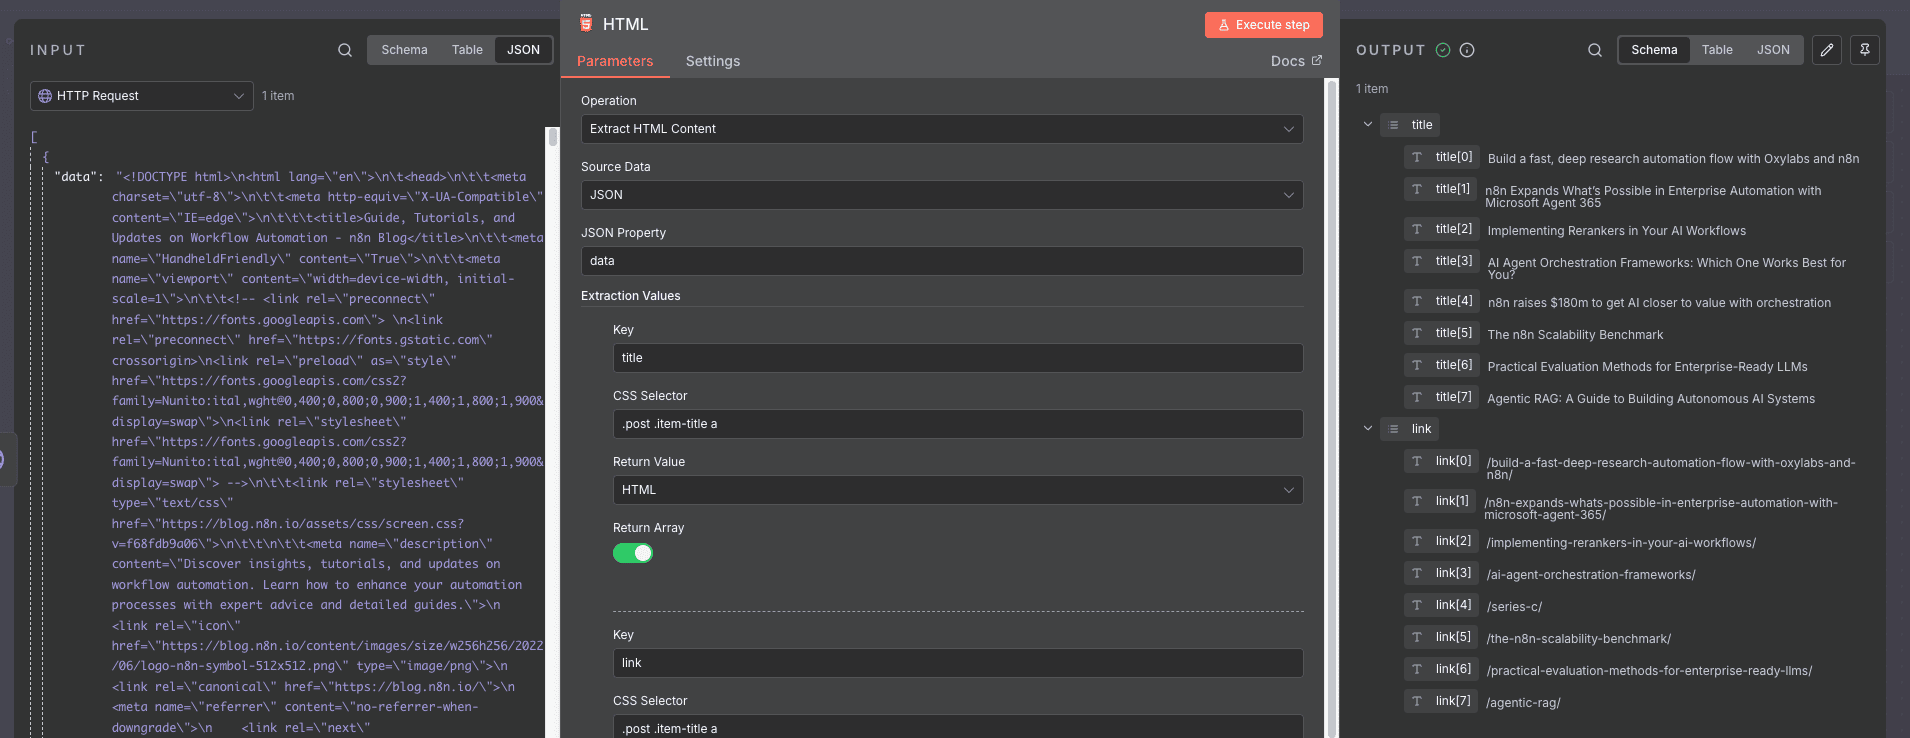
Sekarang kita punya daftar artikel lengkap dengan judul dan link-nya!
Latihan 2: Konversi XML
Mari kembali ke PokéAPI, tapi kali ini kita ubah output JSON-nya menjadi XML.
Tantangan:
-
Ambil data dari
https://pokeapi.co/api/v2/pokemon. - Gunakan node XML untuk mengubah JSON menjadi XML.
👉 Lihat Solusi XML
Langkah 1: HTTP Request (Sama seperti sebelumnya).
Langkah 2: XML Node
- Mode: JSON to XML
- Property Name:
data
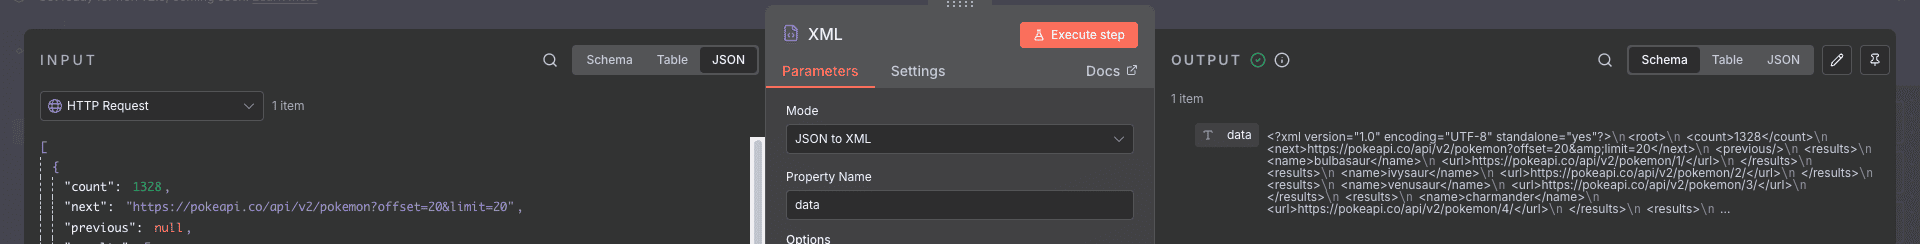
Data Pokemon dalam format XML.
Bagian 2: Tanggal, Waktu, dan Penundaan
Bekerja dengan tanggal seringkali membingungkan karena banyaknya
format (DD-MM-YYYY, ISO, Unix Timestamp, dll).
n8n menyediakan node Date & Time untuk mempermudah konversi dan kalkulasi tanggal. Selain itu, ada node Wait untuk menunda eksekusi (misal: menunggu API lain selesai memproses).
Latihan 3: Manipulasi Tanggal & Wait Node
Skenario latihan yang cukup kompleks:
- Ambil data pelanggan dari node Customer Datastore.
- Bulatkan tanggal pembuatan (created date) ke Akhir Bulan.
-
JIKA tanggal baru tersebut setelah tahun 1960:
- Tunggu selama 1 menit.
- Set field baru
outputValue.
👉 Lihat Solusi Date & Time
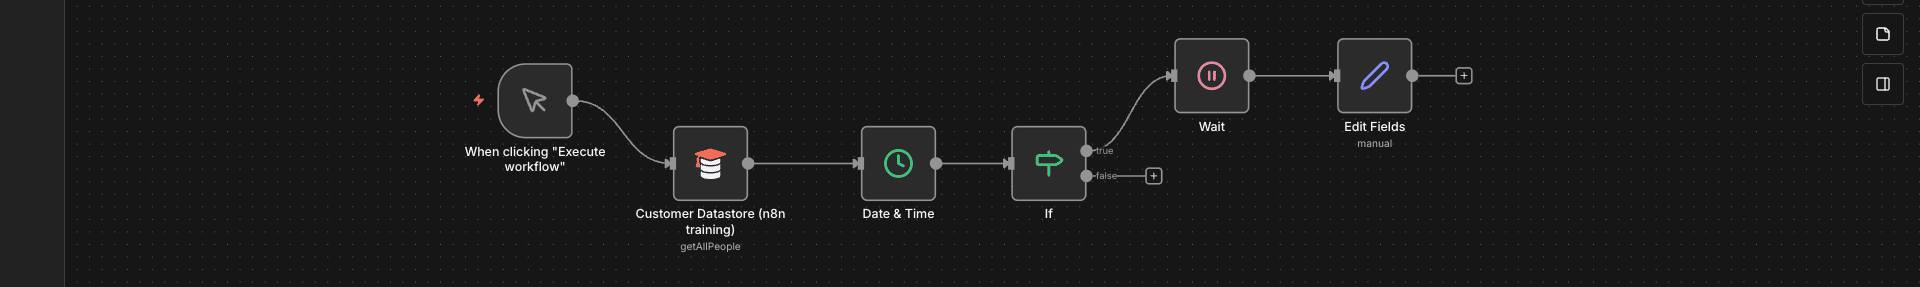
Full Flow
1. Customer Datastore: Get All People.
2. Date & Time Node:
- Operation: Round a Date
- Date:
{{ $json.created }} - Mode: Round Up to End of Month
- Output Field Name:
new-date

Membulatkan tanggal ke akhir bulan.
3. IF Node:
- Value 1:
{{ $json['new-date'] }} - Operator: Date & Time > is after
- Value 2:
1960-01-01 00:00:00
4. Wait Node (di True Branch):
- Resume: After Time Interval
- Wait Amount: 1 Minute
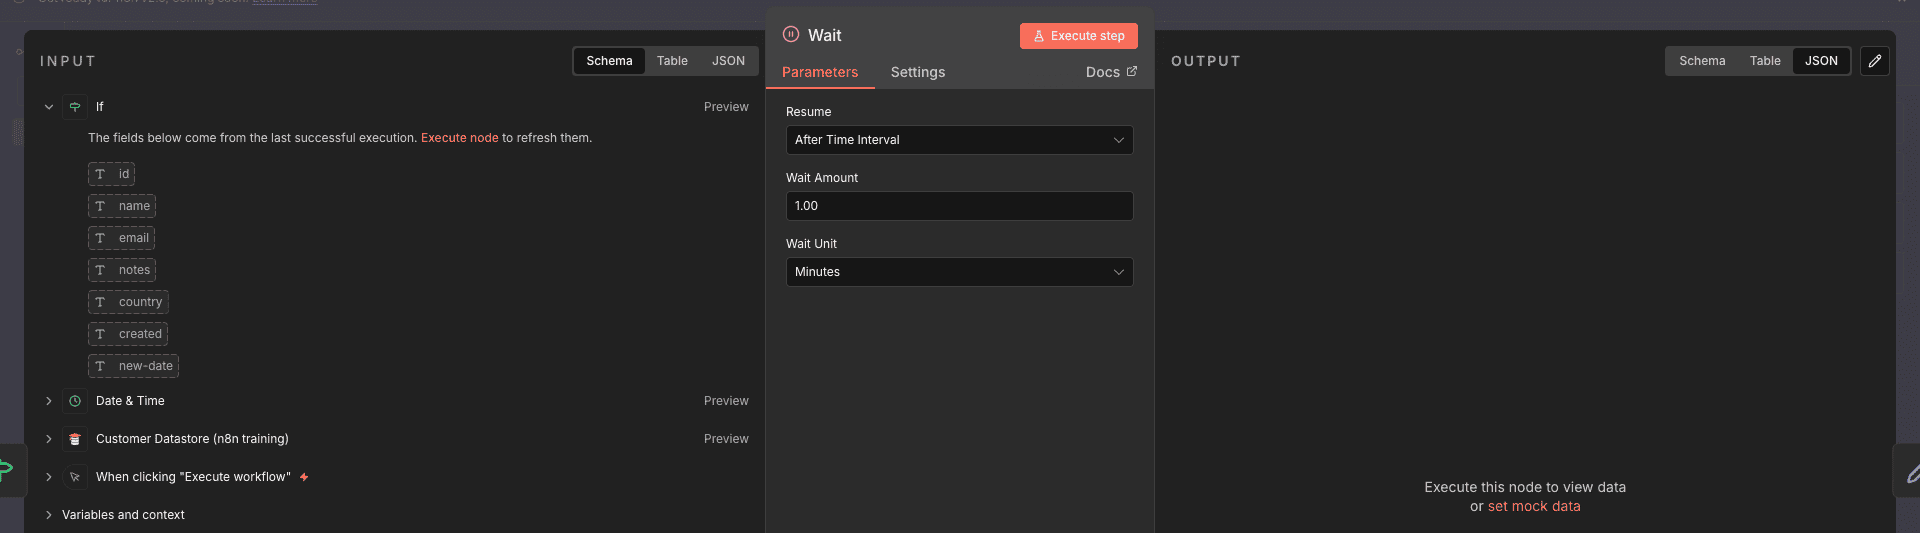
Workflow akan berhenti sejenak di sini.
Bagian 3: Data Biner (File)
Sejauh ini kita hanya bekerja dengan teks (JSON). Tapi bagaimana dengan gambar, PDF, atau file Excel? Di n8n, ini disebut Binary Data.
Node-node penting untuk file:
- HTTP Request: Bisa mendownload file dari internet.
- Read/Write Files from Disk: Membaca/menulis file di server lokal (Hanya Self-Hosted).
- Extract From File: Membaca isi file (misal teks dari PDF).
Latihan 4: PDF ke JSON
Tantangan:
-
Download file PDF dari URL:
https://media.kaspersky.com/pdf/Kaspersky_Lab_Whitepaper_Anti_blocker.pdf - Ekstrak teks dari PDF tersebut menjadi JSON.
👉 Lihat Solusi Binary
1. HTTP Request:
- URL: (Link PDF di atas)
- Perhatikan di Output, sekarang ada tab Binary.
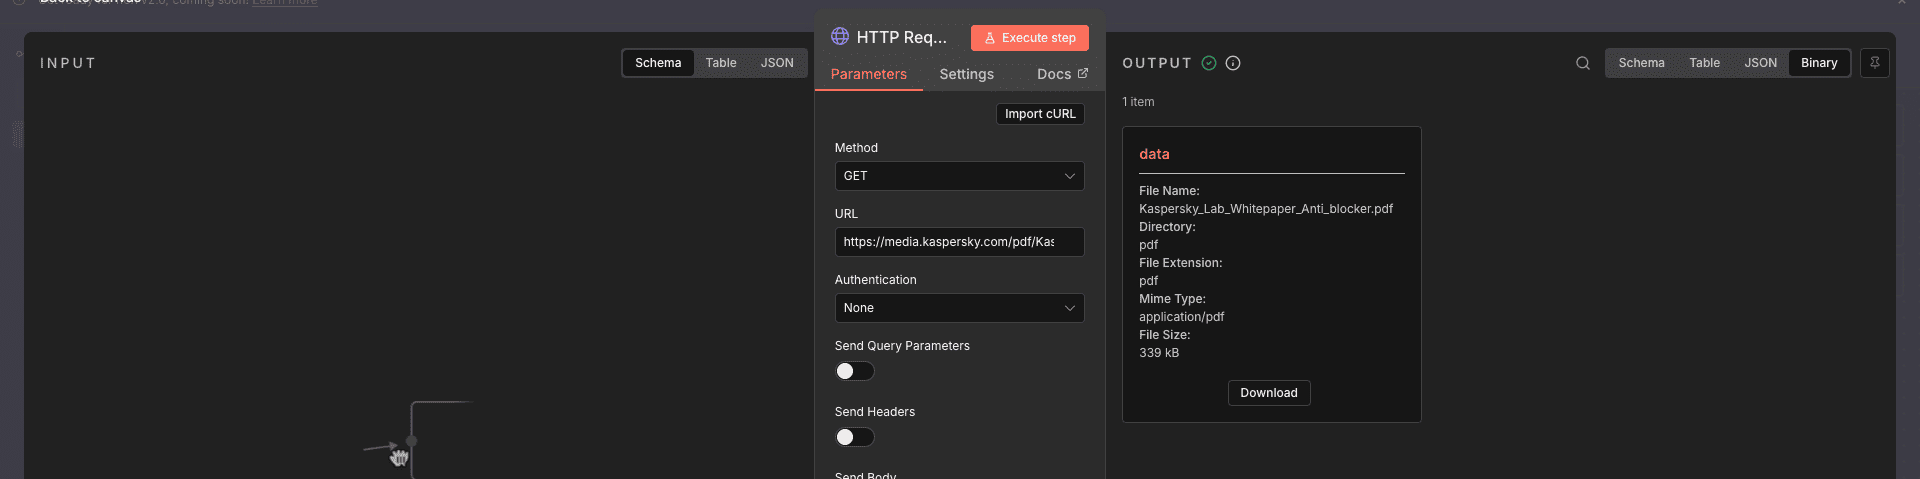
File PDF muncul di tab Binary, bukan JSON.
2. Extract From File:
- Operation: PDF
Hasilnya adalah teks isi PDF yang sudah diubah menjadi JSON yang bisa dibaca!
Ringkasan
Kita 🤵🏻:Ternyata n8n bisa menangani hampir semua jenis data. Dari scraping website, mengubah format tanggal yang rumit, hingga membaca isi file PDF. Ini membuka banyak kemungkinan baru!
Di materi selanjutnya, kita akan membahas topik yang sangat penting untuk menjaga alur kerja tetap bersih: Menggabungkan (Merge) dan Memisahkan Data.